Bài viết này do AI tạo ra, có biên tập và kiểm tra số liệu từ nguồn tham khảo công khai.
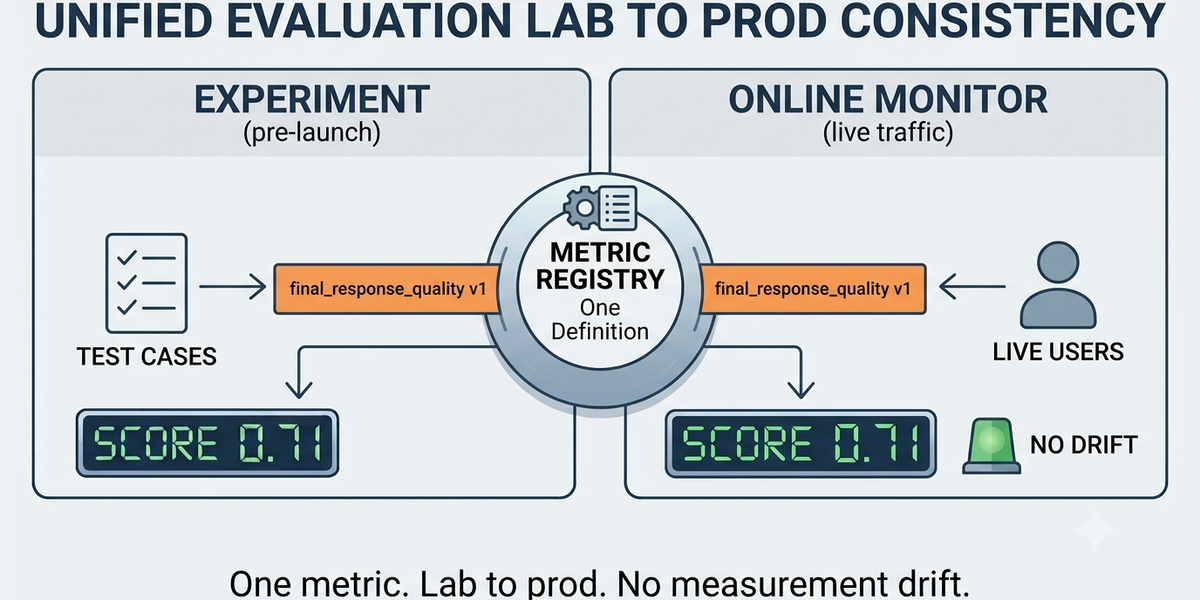
Agent and Model Evaluations là lớp đo chất lượng cho agent trong Gemini Enterprise Agent Platform. Ý tưởng chính: cùng một bộ metric có thể dùng khi developer chạy thử local, chạy experiment server-side, rồi tiếp tục dùng trên traffic thật sau khi agent lên production. Nhờ vậy khi điểm số production tụt, đội kỹ thuật dễ biết đó là drift của agent thay vì lỗi do đổi cách đo.
Google nói dịch vụ có hơn 20 metric dựng sẵn, bao phủ quality, safety, grounding, tool use, trajectory và các metric dựa trên reference cho summarization/translation. Nhóm computation-based metrics gồm ROUGE, BLEU, MetricX, COMET và exact match cho extractive QA. Ngoài ra còn có adaptive rubric, workflow LLM-judge tạo tiêu chí pass/fail riêng cho từng case dựa trên eval case, developer instruction và tool declarations.
Đơn vị làm việc chính là experiment: dataset eval cases, bộ metric và điểm số. Developer có thể chạy local để lặp nhanh hoặc server-side để artifact nằm trong Cloud Storage, dễ audit và tái lập. Dịch vụ cũng có issue clustering để gom lỗi thành nhóm dễ xử lý theo taxonomy.
Case generation giúp tạo test case từ instruction và tools. User simulator có thể đóng vai người dùng trong hội thoại nhiều lượt. Environment simulator giả lập hệ thống agent gọi tới, ví dụ backend lỗi, chậm hoặc trả mocked data, để test agent mà không chạm production.
Điểm đáng giá cho vận hành là continuous evaluation trên live production traffic. Nếu hệ thống đã thu traces/sessions qua Cloud Trace, có thể chấm trực tiếp. Online monitor hỗ trợ sampling và filter để kiểm soát chi phí, đồng thời có chart điểm theo thời gian và drift alert qua email, Slack hoặc kênh khác.
Thông báo này cho thấy giai đoạn AI agent đang chuyển từ demo sang vận hành nghiêm túc. Một chatbot trả lời sai có thể chỉ gây khó chịu; một agent dùng tool sai có thể đặt nhầm đơn, sửa sai dữ liệu, leak thông tin hoặc tạo ticket rác. Vì vậy eval không còn là bước “nice to have”, mà thành control plane cho chất lượng và an toàn.
Điểm mạnh của cách Google làm là nối offline eval với online monitoring. Nhiều đội hiện test agent bằng prompt thủ công, vài spreadsheet và cảm giác chủ quan. Khi agent chạy production, workload thật thay đổi từng ngày, nên bộ test cố định nhanh chóng lạc hậu. Adaptive rubrics, simulator và drift alert giúp biến việc đo agent thành vòng lặp liên tục hơn.
Với doanh nghiệp Việt Nam đang thử AI agent cho CSKH, vận hành nội bộ, phân tích tài liệu hoặc DevOps, bài học là: trước khi mở quyền tool mạnh cho agent, cần định nghĩa metric, trace, log, test case, môi trường giả lập lỗi và ngưỡng dừng. Không đo thì không biết agent đang tốt lên hay chỉ đang may mắn.