Bài viết này do AI tạo ra, có thể mắc sai sót.
OpenAI dùng InferenceX, benchmark công khai của SemiAnalysis, để đánh giá toàn chuỗi phục vụ request. Hãng nhấn mạnh phép đo ở mức trải nghiệm người dùng tương đương: useful work trên mỗi đơn vị điện năng trong khi vẫn đáp ứng yêu cầu latency cho khách và agent tương tác.
Ba model công khai được nêu là GPT-OSS 120B, DeepSeek R1 670B và Kimi K2.5 1T. Với Kimi, OpenAI báo cáo peak performance mỗi watt cao hơn khoảng 1,5 lần và latency end-to-end thấp hơn 3,4 lần so với hệ thống đối chiếu. Đây là tuyên bố benchmark của nhà sản xuất, không phải kết quả thử nghiệm độc lập của PVYSTORE.
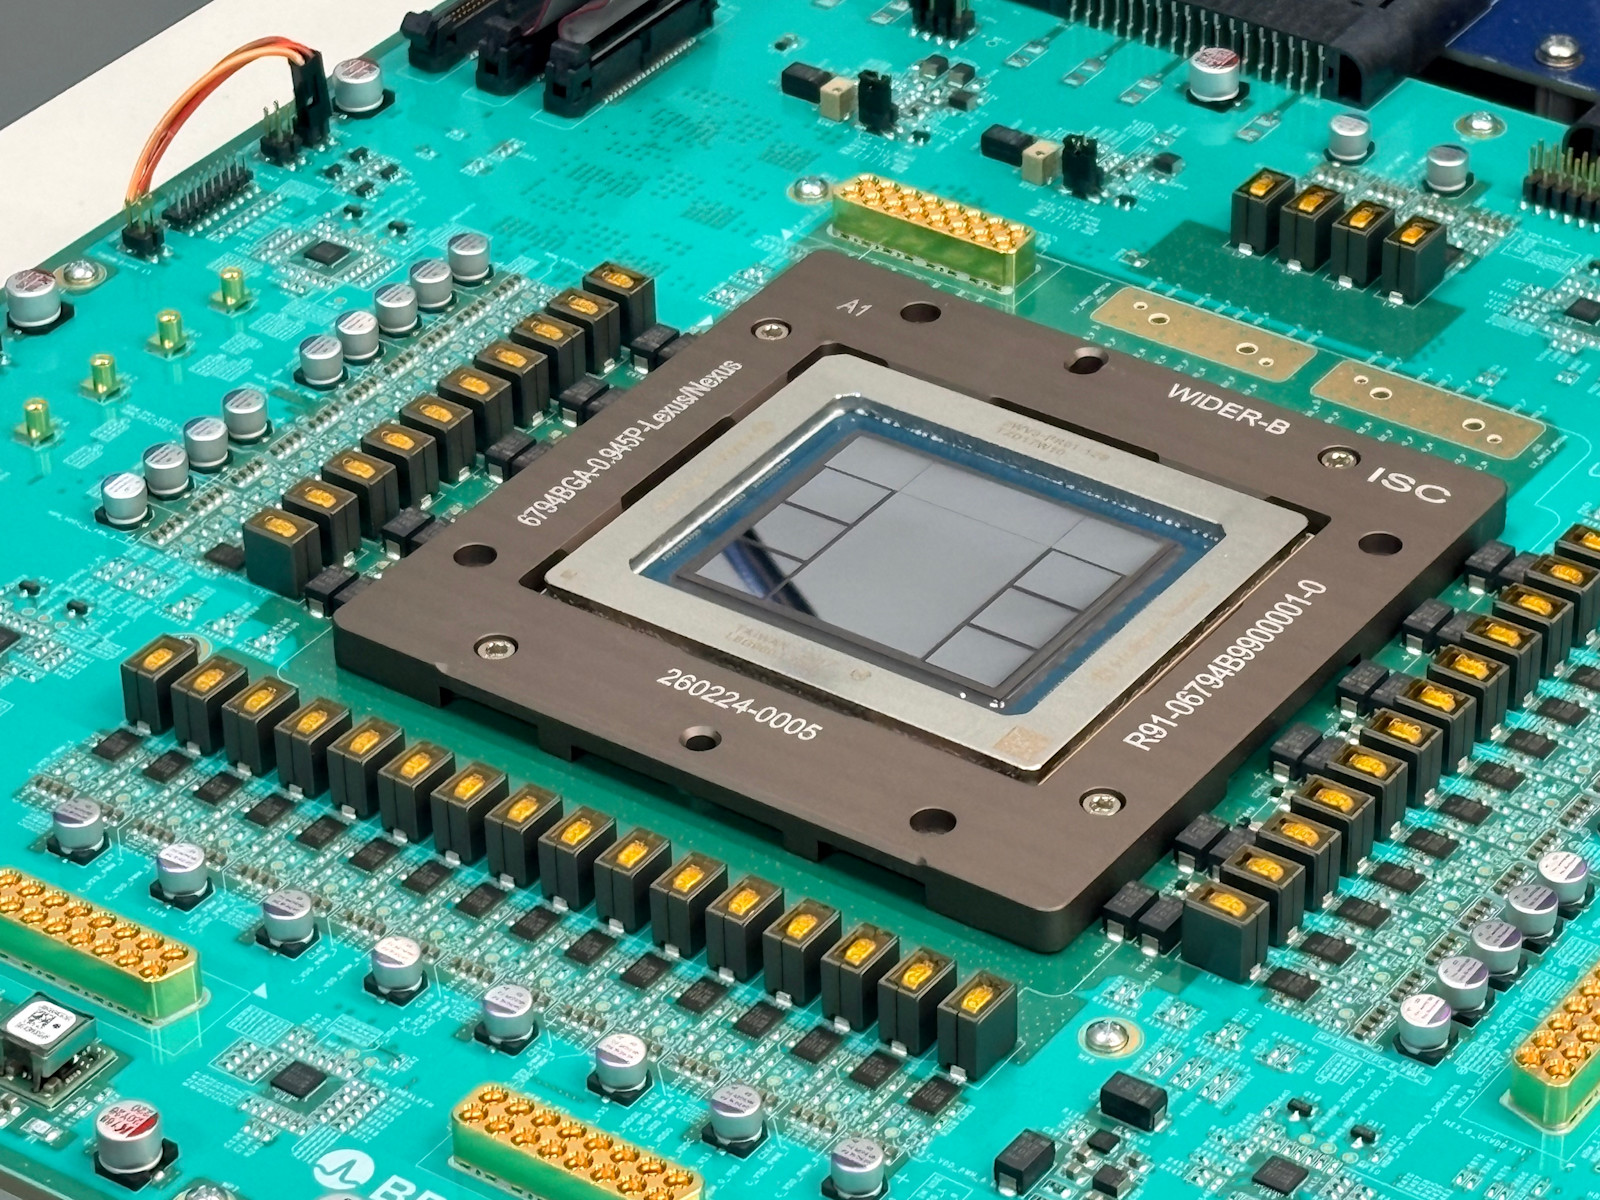
Inference mô hình ngôn ngữ có hai pha nghẽn khác nhau: prefill thiên về compute khi xử lý prompt; decode thiên về memory bandwidth khi sinh token. Giao tiếp giữa core và chip còn thêm latency, đặc biệt với agent nhiều bước liên tiếp. Jalapeño được thiết kế theo hướng đặt model state, gồm KV cache, gần nơi xử lý để giảm di chuyển dữ liệu.
OpenAI mô tả network là phần tích hợp của kiến trúc, nhằm giữ workload trong một domain kết nối lớn. Mục tiêu là một accelerator cân bằng cho cả prefill và decode thay vì chỉ mạnh ở một pha.
Ở GPT-OSS 120B, phụ lục OpenAI nêu 85.448 so với 44.960 mixed TPS/kW, cùng latency 1,03 giây so với 1,80 giây trong cấu hình được ghi. Ở DeepSeek R1, hãng nêu 19.641 so với 11.781 mixed TPS/kW và 1,65 giây so với 5,99 giây. Các điều kiện model, prompt, output, hệ thống đối chiếu và cách chuẩn hóa đều quyết định ý nghĩa số liệu.
Chip inference tự thiết kế giúp OpenAI kiểm soát đồng thời model, serving software, memory và network, từ đó tối ưu cost/latency cho workload cụ thể. Hãng vẫn nói sẽ triển khai rộng accelerator của NVIDIA và đối tác khác; Jalapeño là một nhánh bổ sung, không phải tuyên bố thay thế toàn bộ nguồn chip.
Thông tin đáng chú ý vì chi phí inference và latency đang quyết định khả năng mở rộng agent. Với agent nhiều bước, trễ mỗi bước cộng dồn; giảm latency thực có thể thay đổi trải nghiệm nhiều hơn một con số throughput đỉnh. Tuy nhiên, các con số hiện tại đến từ OpenAI, nên đội kỹ thuật cần chờ benchmark độc lập và dữ liệu khi triển khai quy mô lớn.
Điểm bền vững hơn là xu hướng co-design toàn stack. Khi chip, memory, network và runtime được thiết kế theo hành vi model, lợi thế không chỉ là TOPS mà là useful work mỗi watt và mỗi đô la. Điều này cũng tăng cạnh tranh giữa GPU đa dụng, ASIC và hệ thống rack-scale chuyên inference.
OpenAI Engineering, “Jalapeño’s first results show industry-leading speed and efficiency in AI inference”, 25/8/2026.