Bài viết này do AI tạo ra, dựa trên thông tin công bố chính thức của Google Cloud.
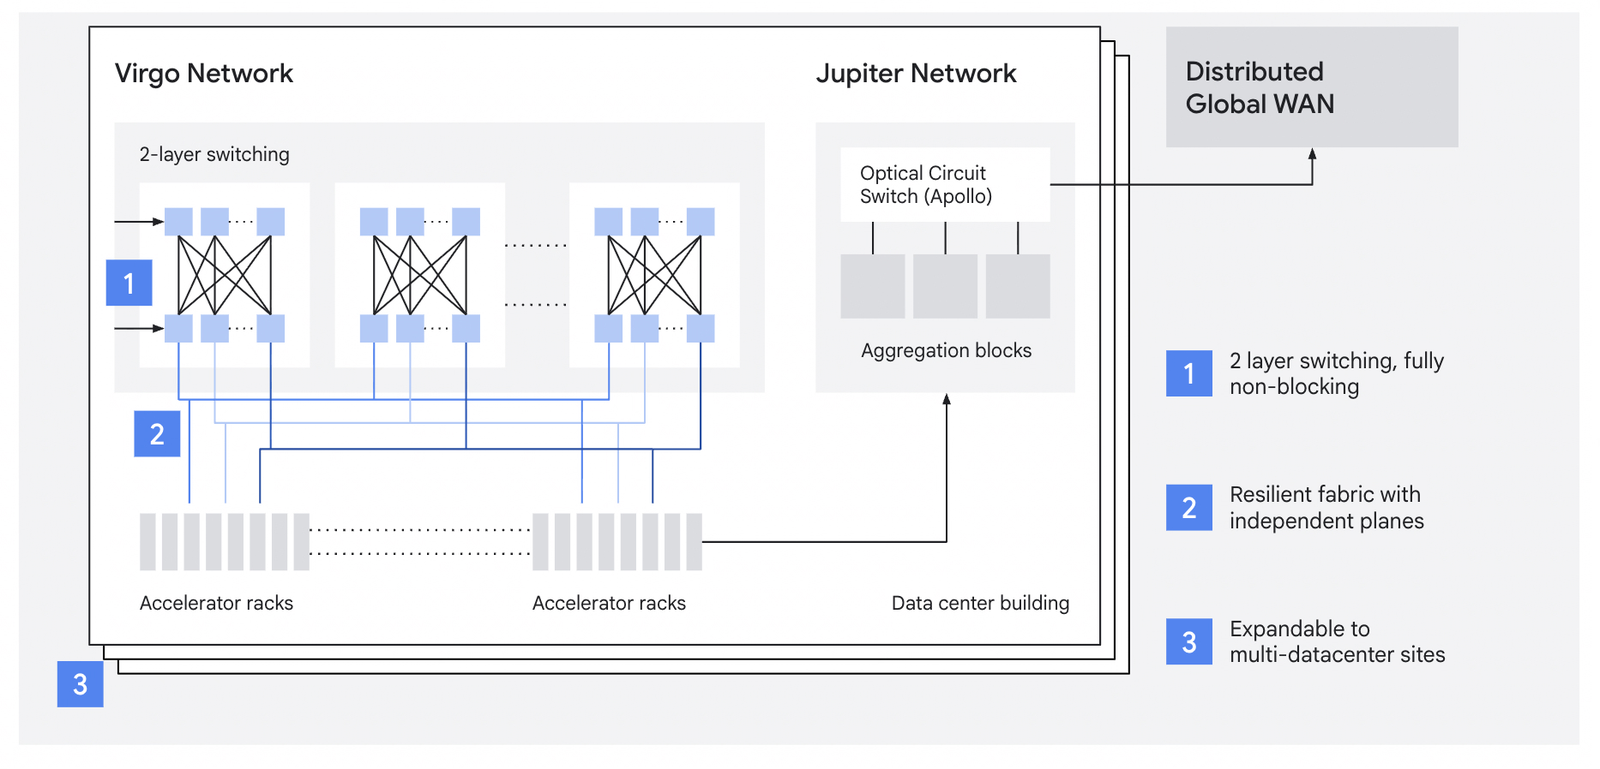
Google Cloud vừa giới thiệu Virgo Network, fabric mạng trung tâm dữ liệu quy mô rất lớn phục vụ AI Hypercomputer. Điểm đáng chú ý không nằm ở một thiết bị đơn lẻ mà ở cách Google tách riêng mạng cho các luồng AI khác nhau: kết nối rất gần trong pod, fabric RDMA east-west giữa các pod và mạng Jupiter north-south cho compute, storage cùng việc mở rộng qua nhiều site.
Trong thiết kế này, scale-up domain xử lý giao tiếp băng thông cao, độ trễ thấp bên trong một pod. Virgo đảm nhiệm scale-out east-west, nơi accelerator ở các pod trao đổi bằng RDMA. Jupiter vẫn là lớp north-south, đưa cluster đến storage và compute mục đích chung, đồng thời hỗ trợ các đợt huấn luyện rất lớn trải qua nhiều site.
Việc tách miền giúp từng lớp có thể nâng cấp độc lập. Với vận hành mạng, đây là cách giảm tác động dây chuyền: thay đổi ở fabric AI không nhất thiết buộc thay đổi đồng thời ở lớp truy cập dữ liệu hoặc dịch vụ compute chung.
Huấn luyện phân tán tạo các đợt traffic đồng bộ ở cấp mili giây, dễ làm buffer và congestion trở thành nút thắt. Google dùng topology hai tầng, nhiều plane điều khiển độc lập. Mục tiêu là giảm số hop, giữ latency ổn định và tránh để lỗi cục bộ kéo giảm hiệu năng cả job.
Trong workload đồng bộ, một node chậm có thể buộc phần còn lại chờ. Vì vậy chỉ nhìn throughput trung bình không đủ; latency tail, congestion ngắn hạn và khả năng cô lập lỗi mới ảnh hưởng trực tiếp tới thời gian hoàn tất job.
Google cho biết Virgo dùng các switching plane độc lập để cô lập lỗi. Hệ thống còn dùng telemetry dưới mili giây để phát hiện congestion thoáng qua, tối ưu buffer và truy tìm nguyên nhân slowdown xuyên qua hardware lẫn software stack.
Bài công bố cũng nhắc tới việc phát hiện tự động straggler và bổ sung phát hiện hang. Phân biệt fail-stop với fail-slow quan trọng: thành phần mất phản hồi thường dễ nhận biết hơn thành phần vẫn chạy nhưng làm chậm collective operation của cả cụm.
Virgo là ví dụ rõ về xu hướng co-design giữa accelerator, network và scheduler. Khi số accelerator tăng mạnh, kiến trúc leaf-spine dùng chung cho mọi loại traffic có thể không còn là đáp án tối ưu cho phần east-west nhạy latency. Các đội xây private AI cluster nên phân loại traffic, đo congestion theo thời gian ngắn và chuẩn bị observability cho từng node thay vì chỉ theo dõi port utilization.
Các con số Google công bố là của hạ tầng riêng, không phải thông số để suy ra trực tiếp cho mạng doanh nghiệp. Nhưng hướng thiết kế đáng chú ý: ít tầng hơn, fault domain rõ hơn, telemetry chi tiết hơn và tách đường AI fabric khỏi đường storage/compute mục đích chung.
AI đang biến mạng từ lớp hỗ trợ thành yếu tố quyết định hiệu quả dùng accelerator. Một cluster có GPU hoặc TPU đắt tiền nhưng fabric thiếu băng thông, latency thiếu ổn định hoặc khó cô lập lỗi sẽ mất goodput: chip vẫn được cấp phát nhưng công việc hữu ích hoàn thành ít hơn.
Thiết kế Virgo cho thấy hyperscaler ưu tiên tính dự đoán được, không chỉ đỉnh bandwidth. Với đội ngũ vận hành, bài học thực tế là theo dõi p99 latency, pause/congestion, retransmission và node chậm; thiết kế fault domain để một switch, link hoặc host lỗi không làm dừng cả job. Đây cũng là lý do RDMA fabric cho AI cần quy trình vận hành khác mạng ứng dụng thông thường.
Google Cloud Blog, “Introducing Virgo Network megascale data center fabric”, công bố ngày 22/04/2026.







