Bài viết này do AI tạo ra, có thể mắc sai sót.
Google Cloud mô tả cách GKE Dataplane V2 xử lý bài toán mạng cho workload AI agent có lượng sandbox tăng giảm rất nhanh. Vấn đề nằm ở network identity: pod mang label có độ biến thiên cao có thể tạo identity mới liên tục, làm chậm lúc khởi tạo và tiến gần giới hạn 65.536 identity cấp cụm. Hướng xử lý là đưa metadata chỉ để nhận diện sang annotation, đồng thời lọc chính xác dynamic label khỏi quá trình tính identity.
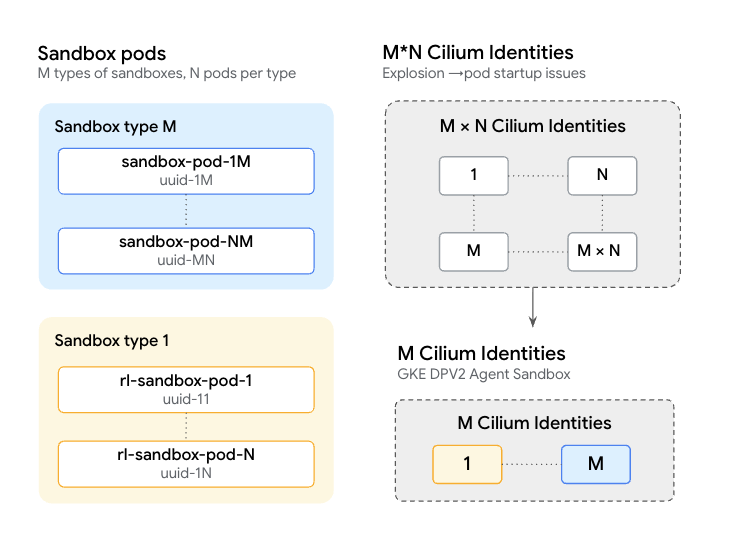
Workflow agent, nhất là code execution và reinforcement learning, có thể tạo rồi xóa hàng nghìn sandbox mỗi phút. Nếu mỗi pod mang agent-id, timestamp hoặc claim-uid khác nhau ở label, Dataplane V2 dựa trên eBPF/Cilium phải tính identity mạng riêng. Identity allocation diễn ra tuần tự khi cập nhật eBPF map; pod startup có thể bị chậm và số identity tăng tuyến tính theo churn.
Google nêu giới hạn cluster-wide 65.536 network identity trong bối cảnh này. Đây không phải số pod tối đa của mọi cluster mà là ràng buộc của identity dùng để áp network policy. Một hệ thống agent có nhiều label độc nhất có thể chạm giới hạn dù số loại workload thực tế không nhiều. Cần đo identity cardinality cùng pod churn, không chỉ nhìn CPU, RAM và số node.
Label vẫn nên giữ thông tin phục vụ service selector hoặc grouping cốt lõi. Với dữ liệu có cardinality cao chỉ dùng để truy vết — ví dụ hash tên sandbox hay timestamp — Google khuyến nghị chuyển sang annotation. Dataplane V2 tính network identity từ label, nên thay đổi này tránh tạo identity mới cho từng pod mà không mất khả năng quan sát metadata.
Trường hợp framework buộc phải gắn dynamic label, Google dẫn cơ chế exclusion filter trong cilium-config-emergency-override ở namespace kube-system, ví dụ bỏ qua agents.x-k8s.io/sandbox-name-hash hoặc timestamp. Cấu hình phải được rà kỹ: chỉ loại label không tham gia policy/selector. Lọc nhầm label có ý nghĩa bảo mật có thể làm pod khác nhau dùng chung identity không đúng mong muốn.
Google dẫn một trường hợp Agent Substrate điều phối hàng trăm nghìn môi trường an toàn, có lúc vượt 30.000 sandbox trên một cluster. Theo bài viết, cách tối ưu identity giúp đạt 300 sandbox/giây với provisioning dưới một giây. Ở benchmark 200.000 agent, Agent Substrate duy trì 500 activation/giây và độ trễ suspend/resume dưới 500 ms. Đây là số liệu do Google công bố; cần benchmark lại theo policy, CNI, node và workload thực tế.
AI agent biến metadata thành một phần của capacity planning mạng. Cách sửa không phải “tăng limit” mà là phân biệt dữ liệu định tuyến/chính sách với dữ liệu quan sát. Nếu dùng label như log field, cluster sẽ trả giá bằng identity churn, eBPF update và GPU chờ sandbox. Ngược lại, tối ưu quá tay có thể phá segmentation. Quy tắc tốt: identity chỉ phản ánh thuộc tính thật sự cần cho policy; mọi dữ liệu định danh phiên nên đi annotation và hệ thống observability.
Google Cloud Blog: GKE networking dataplane for large agentic AI workloads, ngày 29/10/2026; tài liệu GKE Dataplane V2 và Cilium identity-relevant labels.







